情報量
情報理論の情報量(Information Content)は 確率変数 $X$ の実現値 $x$ に関する不確実性を定量化した尺度です。
情報量は以下の性質を満たします。
- 確率 $p(x)$ の単調減少関数である(起こりにくい出来事ほど情報量は大きくなる)
- 確率が $1$(100% 確実に起こる)のときは情報量は $0$ になる
- 確率が $0$ に近づく極限($p(x)\to 0$)で情報量は $\infty$ に発散する(定義そのものは $p(x)>0$ の事象に対してのみ与えられる)
- 独立事象の加法性:確率では $p(A \cap B) = p(A)\,p(B)$ と積で表される独立事象の関係が、情報量では和に変換される
- $I(A \cap B) = -\log_2 p(A \cap B) = -\log_2 \bigl(p(A)\,p(B)\bigr) = -\log_2 p(A) - \log_2 p(B) = I(A) + I(B)$
$x$ が起きる確率を $p(x)$ とすると、情報量 $I(x)$ は以下の式で定義されます(2 を底とする負の対数関数)。
\[I(x) = -\log_2 p(x) \quad x \in \mathcal{X} \ (\text{ただし } p(x) > 0)\]底に 2 を使うのは、2 分の 1(2 択)を基準(1 ビット)にするためです。
$-\log_2 p(x)$ は以下の性質を持ちます。
- 負の対数関数の性質より $p(x)$ は単調減少関数
- 負の対数関数の性質より $p(x) = 1$ のとき $I(x) = 0$
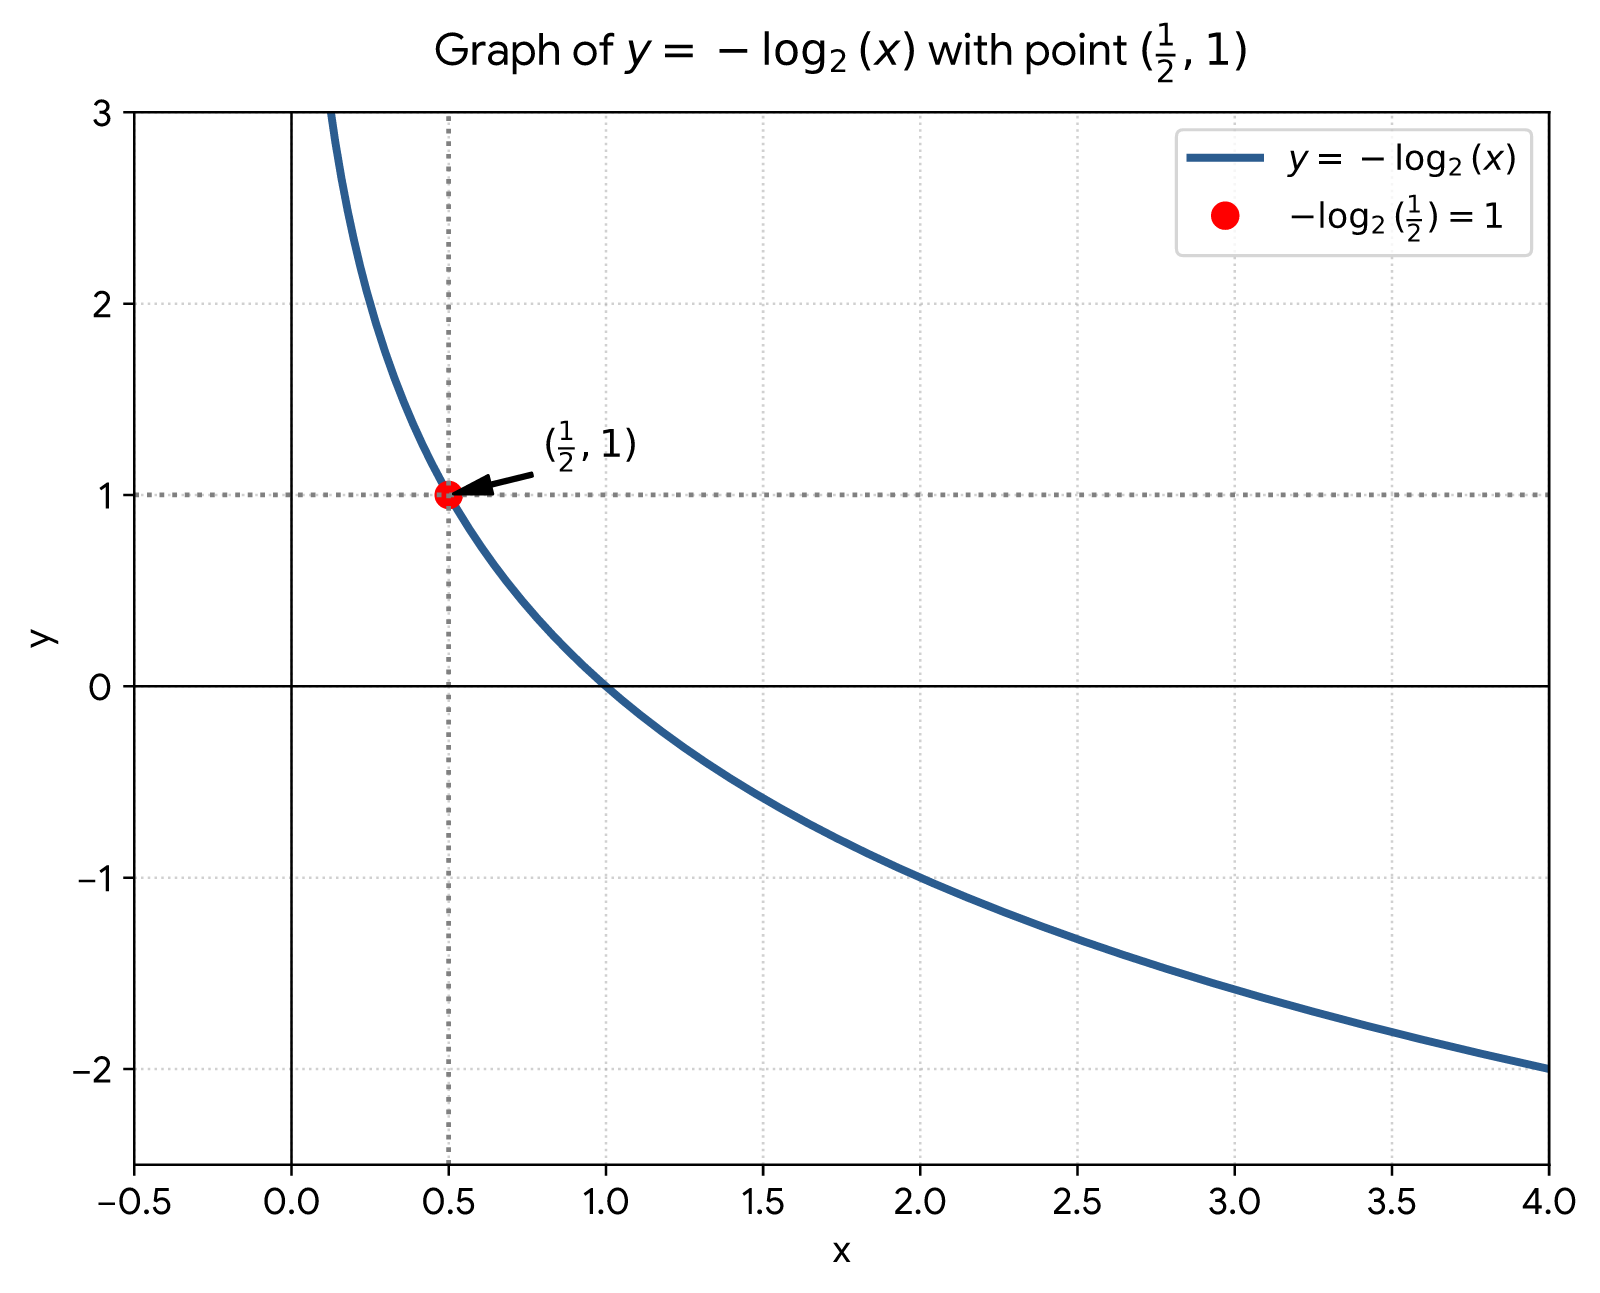
- 底 2 の負の対数関数の性質より $p(x) = \frac{1}{2}$ のとき $I(x) = -\log_2 (\frac{1}{2}) = 1$
- 対数関数の性質より $-\log_2 p(x)p(y) = -(\log_2 p(x) + \log_2 p(y))$
情報量の意味
情報量($I(x) = -\log_2 p(x)$)は、事象 $x$ に対して分布 $p$ のもとで理想的に割り当てるべき符号長(ビット数)です。整数ビットに丸める前の理想値であり、実際の符号長とは必ずしも一致しません(後述)。
- $p(x) = \frac{1}{2}$ なら $-\log_2(\frac{1}{2}) = 1$ ビット
- $p(x) = \frac{1}{4}$ なら $-\log_2(\frac{1}{4}) = 2$ ビット
- $p(x) = \frac{1}{8}$ なら $-\log_2(\frac{1}{8}) = 3$ ビット
起こりやすい事象($p(x)$ が大きい)には短い符号を、起こりにくい事象($p(x)$ が小さい)には長い符号を割り当てるというルールを数式にしたものです。
情報量と実際の符号長の関係
符号長は整数ビットなので、$-\log_2 p(x)$ が整数になるとは限りません。個々の符号長が $-\log_2 p(x)$ と一致するのは、すべての確率が $p(x) = 2^{-k}$($k$ は正の整数)の形をしている特別なケースです。
一般の分布について、シャノンの情報源符号化定理が保証するのは平均符号長です。最適な符号(ハフマン符号など)の平均符号長 $L$ は、エントロピー $H$ に対して次を満たします。
\[H \le L < H + 1\]- 下限:どのような一意復号可能な符号でも、平均符号長はエントロピー $H$ を下回れません(これが「理論的な下限」です。個々の記号の符号長の下限ではありません)
- 上限:ハフマン符号は $H + 1$ 未満の平均符号長を達成します
例:3 つの記号が等確率($p = \frac{1}{3}$)の場合
- 情報量は $-\log_2 \frac{1}{3} \approx 1.585$ ビットですが、ハフマン符号の符号長は $1, 2, 2$ ビットです
- 平均符号長は $\frac{1+2+2}{3} = \frac{5}{3} \approx 1.667$ ビットで、エントロピー $H = \log_2 3 \approx 1.585$ ビットに対して $H \le L < H+1$ を満たします
例(確率が $2^{-k}$ の特別なケース)
次の分布は、すべての確率が $2^{-k}$ の形をしているため、個々の符号長が情報量とちょうど一致し、平均符号長がエントロピーに一致します。
\[p(A)=\frac{1}{2},\quad p(B)=\frac{1}{4},\quad p(C)=\frac{1}{8},\quad p(D)=\frac{1}{8}\] \[A \to 1\text{ビット (0}),\quad B \to 2\text{ビット (10)},\quad C \to 3\text{ビット (110)},\quad D \to 3\text{ビット (111)}\]文字列 AAAABBCD(8 文字)の出現頻度は A:4, B:2, C:1, D:1 なので、出現確率は上記の分布($\frac{1}{2}, \frac{1}{4}, \frac{1}{8}, \frac{1}{8}$)に一致します。
これをハフマン符号で表します。
0,0,0,0,10,10,110,111
エントロピー(1 文字あたりの平均情報量)は次のとおりです。
\[H = \frac{1}{2}\cdot 1 + \frac{1}{4}\cdot 2 + \frac{1}{8}\cdot 3 + \frac{1}{8}\cdot 3 = 1.75 \text{ ビット/文字}\]8 文字分では $1.75 \times 8 = 14$ ビットです。
| 方式 | ビット数 |
|---|---|
| 固定長(2bit×8文字) | 16ビット |
| ハフマン符号 | 14ビット |
| 理論限界(エントロピー × 8文字) | 14ビット |
固定長は文字種4種(A,B,C,D)を区別するため2ビット必要 → 2×8=16ビット。ハフマン符号は14ビットまで縮みます。
詳細は ハフマン符号 を参照してください。
局所的相互情報量
事象 $X=x$ を知ったことによる $Y=y$ の不確実性(自己情報量)の変化量を $x$ と $y$ の局所的相互情報量(point-wise mutual information)と呼び、以下の式で定義します。不確実性が減れば正、増えれば負の値になります。
\[i(x;y) = \bigl(-\log_2 p(y)\bigr) - \bigl(-\log_2 p(y\vert{}x)\bigr) = \log_2 \frac{p(y\vert{}x)}{p(y)}\]$\dfrac{p(y\vert{}x)}{p(y)}$ は、$x$ を知ったことで、$y$ の起こりやすさが何倍に変わったかを表す比です。
- $p(y)$:$x$ を知る前の $y$ の確率(事前の信念)
- $p(y\vert{}x)$:$x$ を知った後の $y$ の確率(更新後の信念)
| 比の値 $\dfrac{p(y\vert{}x)}{p(y)}$ | 意味 | $\log_2$ をとった値($i(x;y)$) |
|---|---|---|
| $>1$ | $x$ を知ると $y$ が起こりやすくなった | 正 |
| $=1$ | $x$ は $y$ について何も教えない(独立) | $0$ |
| $<1$ | $x$ を知ると $y$ が起こりにくくなった | 負 |
局所的相互情報量の対称性
対称性の確認($p(x)>0,\ p(y)>0$ を前提とします): $p(y\vert{}x)p(x) = p(x,y) = p(x\vert{}y)p(y)$ より
\[\begin{aligned} \log_2 \frac{p(y\vert{}x)}{p(y)} = \log_2 \frac{p(y\vert{}x) \times p(x)}{p(y) \times p(x)} \\ = \log_2 \frac{p(x,y)}{p(x)p(y)} = \log_2 \frac{p(x\vert{}y) \times p(y)}{p(x) \times p(y)} = \log_2 \frac{p(x\vert{}y)}{p(x)} \end{aligned}\]となり、 $X$ と $Y$ を入れ替えても値は変わらない。したがって $i(x;y) = i(y;x)$。
- 特定の実現値のペア $(x,y)$ に対して定義される一つの数値
- $\mathcal X \times \mathcal Y$ 上の関数であり、$(x,y)$ が変われば値も変わる
- 符号は正にも負にもなり得る(後述)
相互情報量
$i(x;y)$ を同時分布 $p(x,y)$ のもとで期待値を取ったものが相互情報量です。
\[I(X;Y) = \mathbb{E}_{(x,y)\sim p(x,y)}\bigl[\, i(x;y) \,\bigr] = \sum_{x \in \mathcal{X}} \sum_{y \in \mathcal{Y}} p(x,y) \log_2 \frac{p(x,y)}{p(x)\,p(y)}\]- $i(x;y)$ を同時分布 $p(x,y)$ で平均した一つのスカラー値(期待値)
- $X$ と $Y$ の統計的な依存性の大きさを表す量(線形な関係に限らず、あらゆる形の依存を捉える)
- 常に非負($I(X;Y)\ge 0$)
$i(x;y)$ が負になり得る例
$i(x;y) = \log_2 \dfrac{p(y\vert{}x)}{p(y)}$ です。これは $X=x$ を知ったことで $p(y\vert{}x)$ が周辺確率 $p(y)$ より大きくなったか小さくなったかで符号が決まります。
- $p(y\vert{}x) > p(y)$ なら $i(x;y) > 0$ ($X=x$ を知ると $Y=y$ が起こりやすくなった)
- $p(y\vert{}x) < p(y)$ なら $i(x;y) < 0$ ($X=x$ を知ると $Y=y$ が起こりにくくなった)
つまり、特定の組み合わせ $(x,y)$ については不確実性が増すこともあり得るため、$i(x;y)$ 自体は負の値を取り得ます。
具体例:天気と傘
同時分布 の天気($X$)と傘の持参($Y$)の表を使います。
| 傘を持つ | 傘を持たない | 周辺確率 | |
|---|---|---|---|
| 晴れ | 0.1 | 0.4 | 0.5 |
| 雨 | 0.4 | 0.1 | 0.5 |
| 周辺確率 | 0.5 | 0.5 |
各組み合わせの局所的相互情報量は次のとおりです。
| $(x, y)$ | $p(x,y)$ | $p(x)p(y)$ | $i(x;y)=\log_2\dfrac{p(x,y)}{p(x)p(y)}$ |
|---|---|---|---|
| (晴れ, 傘を持つ) | 0.1 | 0.25 | $\log_2 0.4 \approx -1.32$ |
| (晴れ, 傘を持たない) | 0.4 | 0.25 | $\log_2 1.6 \approx +0.68$ |
| (雨, 傘を持つ) | 0.4 | 0.25 | $\log_2 1.6 \approx +0.68$ |
| (雨, 傘を持たない) | 0.1 | 0.25 | $\log_2 0.4 \approx -1.32$ |
「晴れ」と分かった上で「傘を持つ」という組み合わせは、独立の場合(0.25)より起こりにくいため $i(x;y)<0$ になります。
一方、この $i(x;y)$ を $p(x,y)$ で重み付けして平均すると次のとおり正の値になります。
これは $H(Y) - H(Y\vert{}X) = 1 - 0.722 \approx 0.278$ ビットとも一致します。
このように、個々の $i(x;y)$ は負になり得ますが、同時分布全体で平均した $I(X;Y)$ は KL ダイバージェンスとして常に非負になります(ギブスの不等式、後述)。
エントロピーとの関係の導出
\[\begin{aligned} I(X;Y) &= \sum_{x,y} p(x,y) \log_2 \frac{p(y\mid x)}{p(y)} \\ &= \sum_{x,y} p(x,y) \log_2 p(y\mid x) \;-\; \sum_{x,y} p(x,y) \log_2 p(y) \\ &= -H(Y\mid X) \;+\; \Bigl(-\sum_{y}\Bigl(\sum_{x} p(x,y)\Bigr) \log_2 p(y)\Bigr) \\ &= -H(Y\mid X) \;+\; \Bigl(-\sum_{y} p(y) \log_2 p(y)\Bigr) \\ &= -H(Y\mid X) \;+\; H(Y) \\ &= H(Y) - H(Y\mid X) \end{aligned}\]- 2 行目 → 3 行目:第 1 項は条件付きエントロピーの定義より $\sum_{x,y} p(x,y)\log_2 p(y\mid x) = -H(Y\mid X)$ です。第 2 項は「$-\sum_{x,y} p(x,y)\log_2 p(y)$」なので、そのまま「$+\bigl(-\sum_{x,y} p(x,y)\log_2 p(y)\bigr)$」と書けます(括弧内は非負の量)。引き算の符号をそのまま括弧の外に残さないよう注意します
- 3 行目 → 4 行目:周辺化 $\sum_x p(x,y) = p(y)$ を使っています
- 4 行目 → 5 行目:$-\sum_y p(y)\log_2 p(y)$ はエントロピーの定義そのもので $H(Y)$ です
対称性 $i(x;y)=i(y;x)$ より、同様に
\[I(X;Y) = H(X) - H(X\mid Y)\]も成り立つ。
さらに、$\log_2 \dfrac{p(x,y)}{p(x)p(y)} = \log_2 p(x,y) - \log_2 p(x) - \log_2 p(y)$ を使えば
\[I(X;Y) = H(X) + H(Y) - H(X,Y)\]も直接導ける(これは結合エントロピー $H(X,Y)$ の全体式と対応する)。
非負性(数学的厳密性の補足)
$I(X;Y)\ge 0$ であることは、$I(X;Y)$ が $p(x,y)$ と $p(x)p(y)$ の間の KL ダイバージェンス
\[I(X;Y) = D_{\mathrm{KL}}\bigl(p(x,y)\,\|\,p(x)p(y)\bigr) = \sum_{x,y} p(x,y)\log_2\frac{p(x,y)}{p(x)p(y)}\]に等しく、KL ダイバージェンスが常に非負である(ギブスの不等式)ことから従う。
ギブスの不等式の導出(イェンセンの不等式)
$\log_2$ は上に凸(凹関数)なので、重み $p(x,y)$ による期待値に対してイェンセンの不等式 $\mathbb{E}[\log_2 Z] \le \log_2 \mathbb{E}[Z]$ が成り立ちます。$p(x,y)>0$ となる $(x,y)$ の集合を $S$ として、
\[\begin{aligned} -I(X;Y) &= \sum_{(x,y)\in S} p(x,y)\log_2\frac{p(x)p(y)}{p(x,y)} \\ &\le \log_2 \sum_{(x,y)\in S} p(x,y)\cdot\frac{p(x)p(y)}{p(x,y)} \\ &= \log_2 \sum_{(x,y)\in S} p(x)p(y) \\ &\le \log_2 1 = 0 \end{aligned}\]したがって $I(X;Y)\ge 0$ です。
等号 $I(X;Y)=0$ は $p(x,y)=p(x)p(y)$、すなわち $X$ と $Y$ が独立な場合に限り成立する。
連続確率変数の場合
連続確率変数では、エントロピーは微分エントロピー $h(X) = -\int f(x)\log_2 f(x)\,dx$ になります。
- 微分エントロピーは負の値を取り得ます(離散エントロピーは常に $0$ 以上です)
- 相互情報量 $I(X;Y) = h(X) + h(Y) - h(X,Y)$ は連続の場合でも KL ダイバージェンスとして常に非負です
NOTE
「不確実性がなければエントロピーは $0$」という性質は離散確率変数に対するものです。
補足
$\frac{1}{2}$ の情報量 $-\log_2(\frac{1}{2}) = 1$ を表したグラフです。
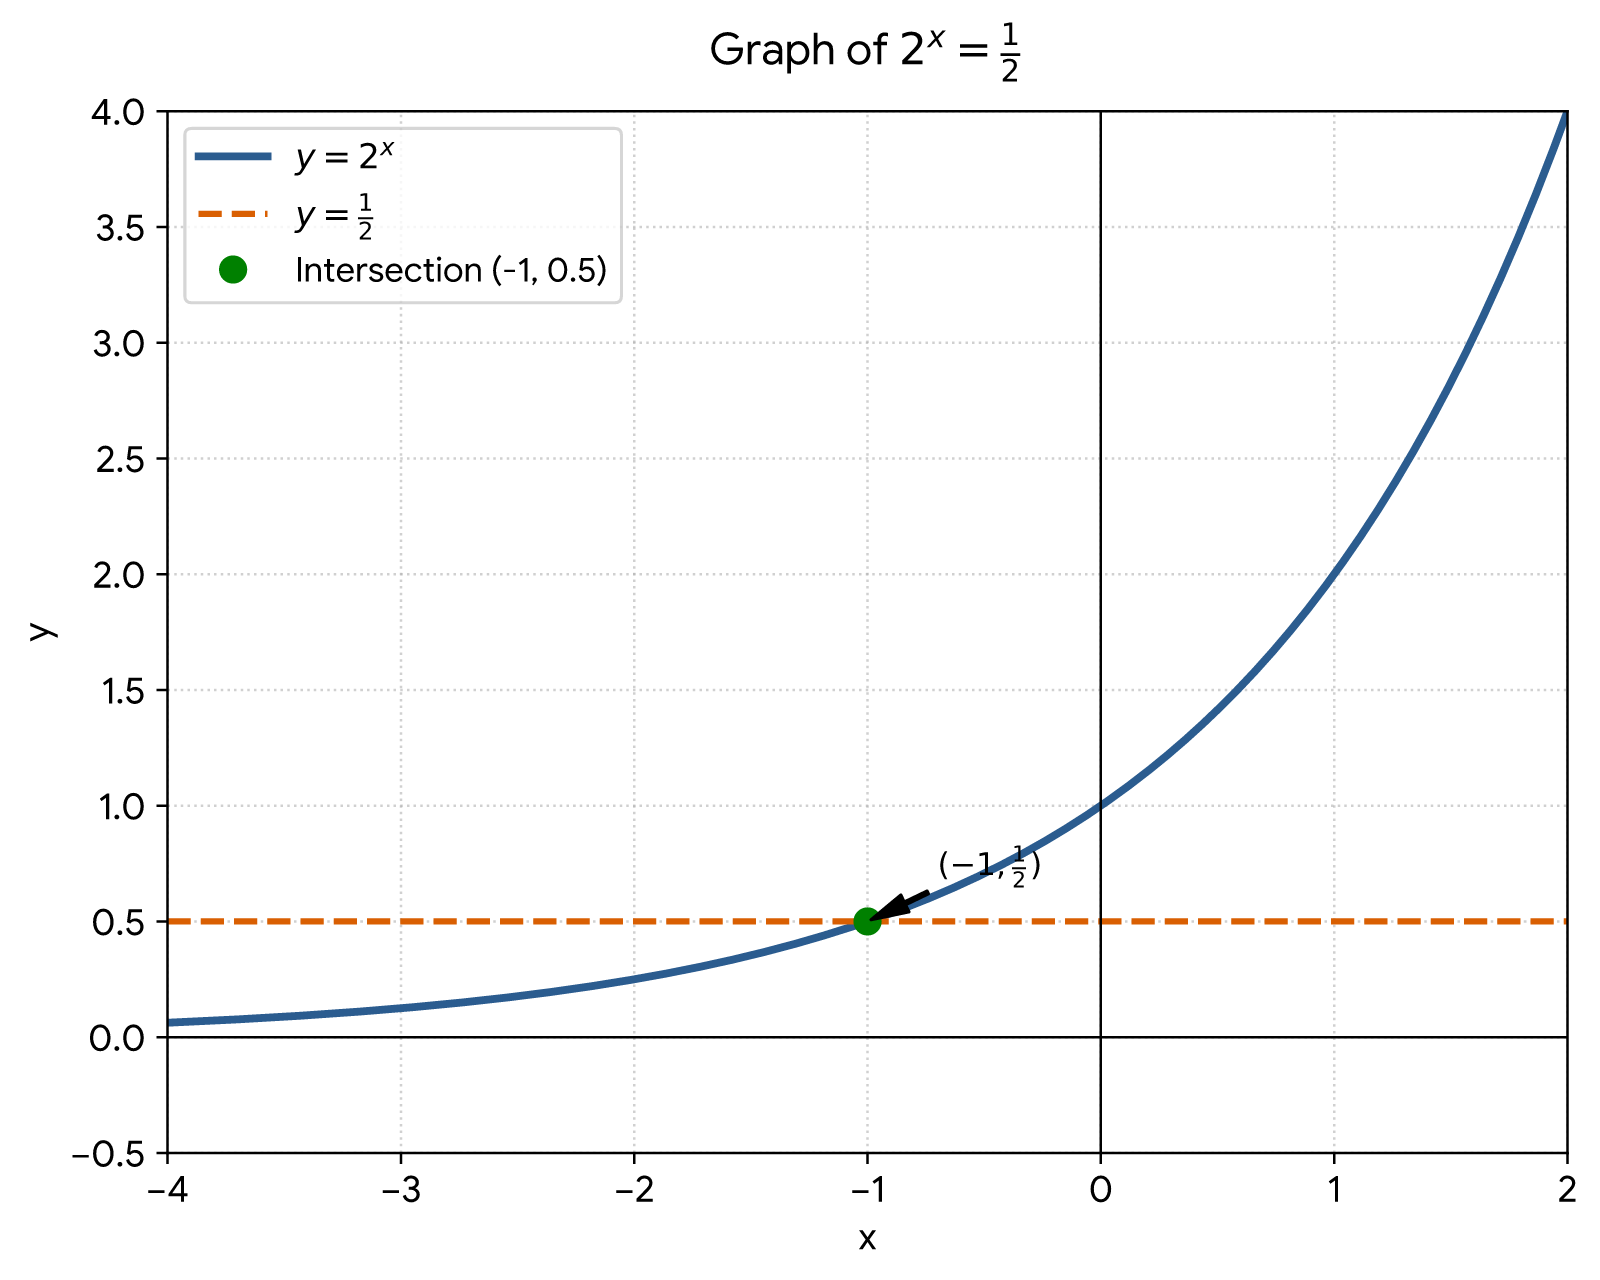
参考までに指数関数のグラフも記載します。