ディリクレ分布 | 確率・統計
カテゴリカル分布 のパラメータ $\boldsymbol{p}=(p_1,\dots,p_M)$ を確率変数とみなし、その不確実性を表現するための分布がディリクレ分布です。ベータ分布 を $M\ge2$ に一般化したものにあたります。
カテゴリカル分布とディリクレ分布の違い
| カテゴリカル分布 | ディリクレ分布 | |
|---|---|---|
| 変数 | $\boldsymbol{x}$(観測値、one-hot ベクトル) | $\boldsymbol{p}$(各カテゴリの確率そのもの) |
| 定義域 | $M$個の頂点(離散) | シンプレックス(連続) |
| パラメータ | $\boldsymbol{p}$($M$個、固定値とみなす) | $\boldsymbol{\alpha}=(\alpha_1,\dots,\alpha_M)$($M$個) |
| 役割 | データが従う分布 | データが従う分布のパラメータ $\boldsymbol{p}$ が従う(と仮定する)分布 |
シンプレックス
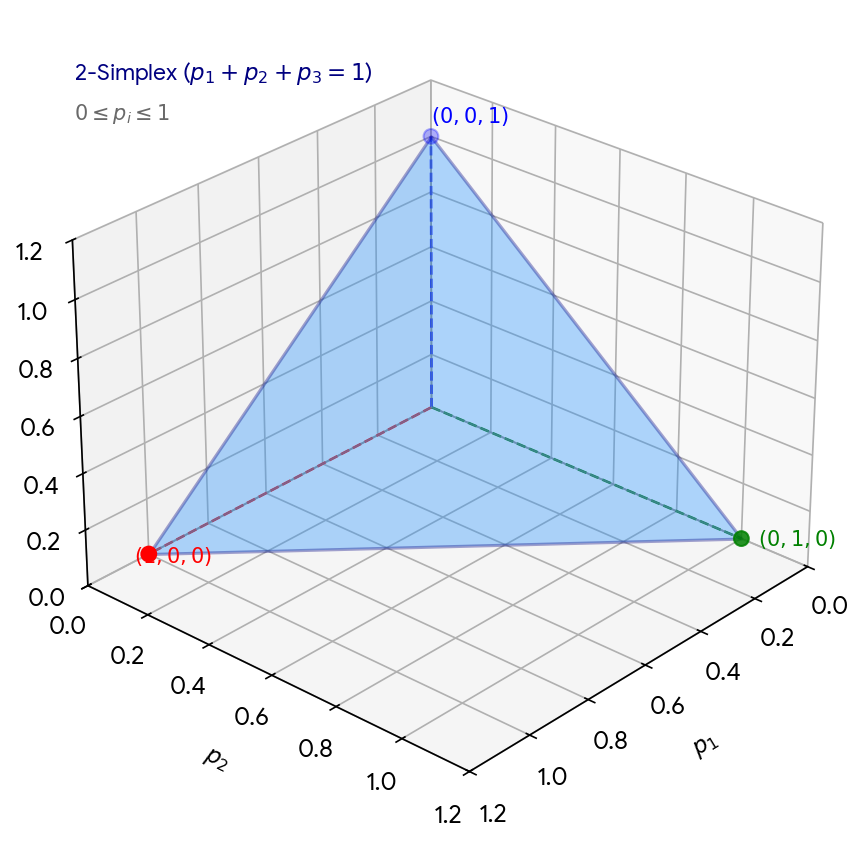
カテゴリカル分布のパラメータ $\boldsymbol{p}$ は、 $\sum_{j=1}^M p_j = 1, \quad p_j \ge 0$ という制約があります。 この制約を満たす領域をシンプレックス(単体)と呼びます。
例えば $M=3$(サイコロの目が3種類)なら、$\boldsymbol{p}=(p_1,p_2,p_3)$ が動ける範囲は三角形の面上、というイメージです。
3 次元のシンプレックス:
確率密度関数
\[P(\boldsymbol{p}) = \frac{1}{B(\boldsymbol{\alpha})}\prod_{j=1}^{M} p_j^{\alpha_j-1} \qquad \boldsymbol{p}\in\text{シンプレックス}\]$B(\boldsymbol{\alpha})$ は正規化定数(多変量ベータ関数)です。$\boldsymbol{\alpha}=(\alpha_1,\dots,\alpha_M)$ は各 $\alpha_j>0$ を満たす必要があり、ベータ分布 の $\alpha,\beta>0$ の制約と同じ理由($p_j\to0$ での発散を防ぐため)です。
$\alpha_j$ は直感的には「カテゴリ $j$ が事前にどれだけ起きやすいと信じているか」を表す仮想的な出現回数のようなものです。
具体例(サイコロ、$M=6$)
- $\boldsymbol{\alpha}=(1,1,1,1,1,1)$(全部同じ)→ どの目が出やすいかについて「白紙」の状態。$\boldsymbol{p}=(1/6,\dots,1/6)$ 付近もそれ以外の偏った $\boldsymbol{p}$ も同じくらいありえる、というフラットな信念。
- $\boldsymbol{\alpha}=(10,1,1,1,1,1)$ → 「1の目が出やすいサイコロだろう」という信念が強く反映された状態。$p_1$ が大きい $\boldsymbol{p}$ の方が事前確率が高い。
カテゴリカル分布 + ディリクレ事前分布 → 事後分布もディリクレ分布(共役事前分布)
$N$ 回の観測のうち、カテゴリ $j$ が出現した回数を $N_j$ とします(尤度関数 を参照)。カテゴリカル分布の尤度は
\[L(\boldsymbol{p}) = \prod_{j=1}^{M} p_j^{N_j}\]事前分布を $\text{Dirichlet}(\boldsymbol{\alpha})$ とすると、事後分布は「事前分布 × 尤度」に比例するので、
\[\underbrace{\prod_{j=1}^{M} p_j^{\alpha_j-1}}_{\text{事前分布}} \times \underbrace{\prod_{j=1}^{M} p_j^{N_j}}_{\text{尤度}} = \prod_{j=1}^{M} p_j^{(\alpha_j-1)+N_j}\]指数同士を足すだけで、これは $\text{Dirichlet}(\alpha_1+N_1,\ \dots,\ \alpha_M+N_M)$ の形そのものです。積分をして正規化定数を求めなくても、「形」を見ただけで事後分布が分かってしまいます。
\[P(\boldsymbol{p}\mid\text{データ}) = \text{Dirichlet}(\alpha_1+N_1,\ \dots,\ \alpha_M+N_M)\]直感:「仮想的な観測回数」の合体
\[\underbrace{\alpha_j}_{\text{事前の仮の回数}} + \underbrace{N_j}_{\text{実際の観測回数}} = \underbrace{\alpha_j+N_j}_{\text{更新後の総合回数}}\]データが増えるほど $N_j$ が $\alpha_j$ に対して支配的になり、事前の主観の影響は薄れていきます。
具体例
サイコロを1回だけ振って「3の目」が出たとします($N_3=1$、他の $N_j=0$)。事前分布を $\boldsymbol{\alpha}=(1,1,1,1,1,1)$(白紙)とすると、事後分布は
\[\text{Dirichlet}(1{+}0,\ 1{+}0,\ 1{+}1,\ 1{+}0,\ 1{+}0,\ 1{+}0) = \text{Dirichlet}(1,1,2,1,1,1)\]「3の目が少しだけ出やすいサイコロかもしれない」という、たった1回の観測を反映した事後分布が、積分計算なしに一瞬で求まります。
$\alpha,\beta \leftrightarrow \boldsymbol{\alpha}$ の対応($M=2$ の特殊ケース)
ディリクレ分布で $M=2$ とすると、$p_2=1-p_1$ という制約により実質1つのパラメータ $p_1=p$ に退化し、$\boldsymbol{\alpha}=(\alpha_1,\alpha_2)=(\alpha,\beta)$ と対応します。この特殊ケースがベータ分布であり、ベルヌーイ分布とベータ分布 の関係とちょうど同じ構造です。
一般の場合(共役でない場合)は難しい
共役事前分布(カテゴリカル分布+ディリクレ分布など)が使える場合は、積分を実行することなく解析的に閉じた式(足し算のみ)で事後分布が求まります。
一方、事前分布を自由に選びたい場合や、モデルがもっと複雑(例:ニューラルネットワークのパラメータなど)になると、正規化定数の積分は解析的に解けなくなります。この場合の対処法として、
- MCMC(マルコフ連鎖モンテカルロ法):事後分布から大量にサンプルを生成し、そのサンプル群で分布の形を近似する
- 変分推論(Variational Inference):真の事後分布を扱いやすい別の分布族で近似し、両者の差(KLダイバージェンス)を最小化するパラメータを最適化で求める
などが使われます。ディープラーニングのような高次元モデルでは、解析的な共役事前分布はほぼ使えないため、これらの近似手法が中心になります。