一変量正規分布 | 確率・統計
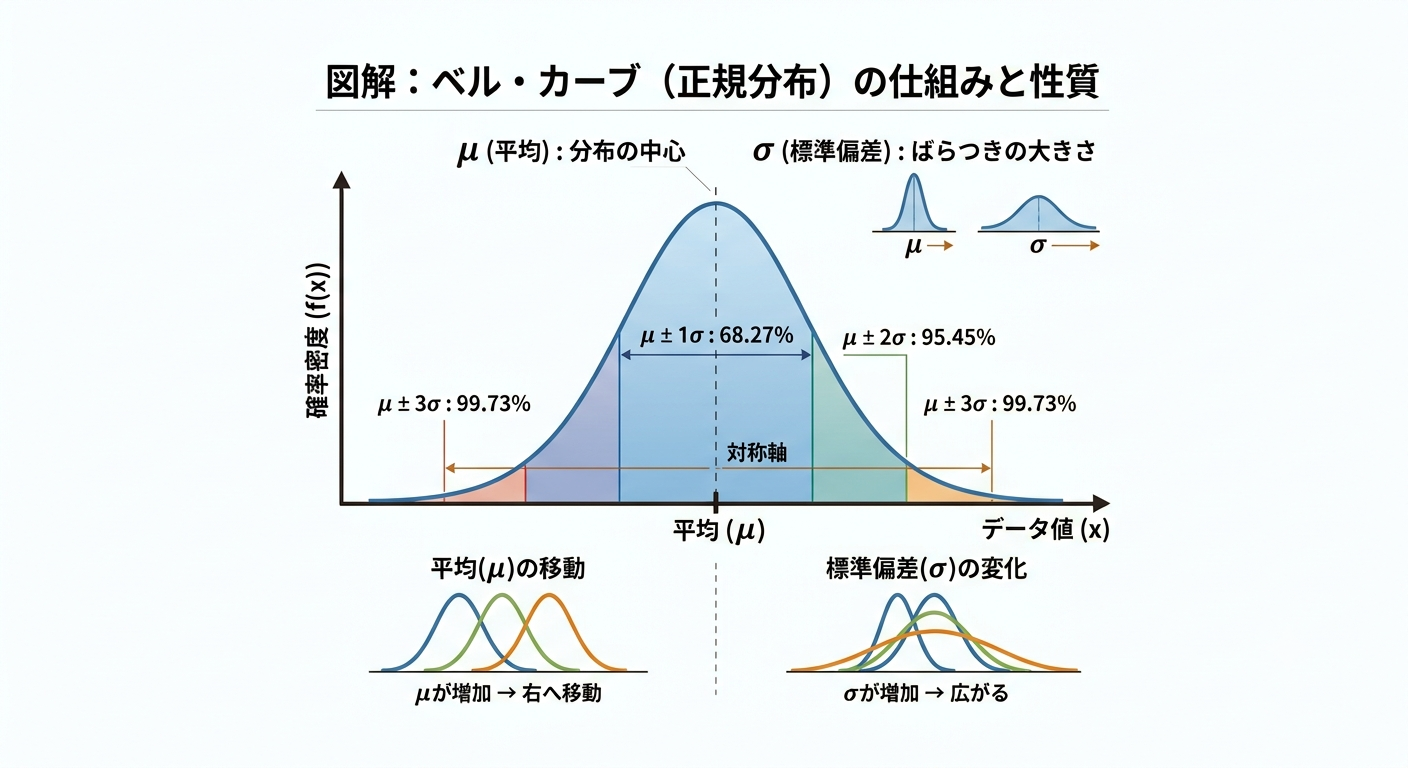
一変量正規分布(Univariate Normal Distribution)の形は、平均($\mu$)と分散($\sigma^2$)の 2つの値だけで決まります($N(\mu, \sigma^2)$ と記載、$N$ は Normal の頭文字)。
- 平均 ($\mu$, ミュー): 分布の中心を表します
- 標準偏差 ($\sigma$, シグマ): 分布の広がり具合を表します。標準偏差を 2 乗したものが分散 ($\sigma^2$)です
- $\sigma$ が小さい:平均付近にデータが集中します
- $\sigma$ が大きい:山が低く横に広がり、データが散らばっています
確率密度関数
\[f(x) = \frac{1}{\sqrt{2\pi\sigma^2}} \exp\left( -\frac{(x - \mu)^2}{2\sigma^2} \right)\]- $(x - \mu)^2$:平均からどれだけ離れているか(距離の 2 乗)を表します
- マイナス($-$)がついた指数関数($\exp$): 平均から離れれば離れるほど、分子が大きくなり、マイナスがついているため全体の数値(確率)は急激に小さくなります。これが「中心が高く、両端が急に低くなる」鐘型の正体です。
- $\frac{1}{\sqrt{2\pi\sigma^2}}$ の部分: グラフの下側の総面積を 1(確率の合計)にするための調整用(正規化定数)です
性質
- $\mu \pm 1\sigma$ の範囲: 全データの 約 68.3% が収まる
- $\mu \pm 2\sigma$ の範囲: 全データの 約 95.4% が収まる(統計的仮説検定の 5% 有意水準などの基準によく使われます)
- $\mu \pm 3\sigma$ の範囲: 全データの 約 99.7% が収まる(品質管理の
6シグマなどはこれがベースです)
標準正規分布(Standard Normal Distribution)
平均 $\mu = 0$、分散 $\sigma^2 = 1$ に変換(標準化)したもの を指します。
任意の正規分布に従う変数 $X$ は、 $Z = \frac{X - \mu}{\sigma}$ と変換することで、$N(0, 1)$ に変換できます。
3つの分布
中心極限定理を理解するには、3つのレイヤを分けて考える必要があります。
- 母集団の分布(もとのデータ):
- 分布はどのような形状でもよい。サンプルサイズ($n$)をどれだけ大きくしても、この形はかわらない
- 1 回のサンプリング(抽出されたデータ):
- 母集団からランダムに $n$ 個のデータを取ってきたもの。$n$ を大きくすればするほど、このサンプルのヒストグラムは母集団分布(
1.)の形状に近づく
- 母集団からランダムに $n$ 個のデータを取ってきたもの。$n$ を大きくすればするほど、このサンプルのヒストグラムは母集団分布(
- 標本平均の分布(中心極限定理の扱う分布):
平均値が正規分布になるメリット
メリット1:不確実性の幅(エラーバー)が計算できる
例えば、日本人の平均年収(真の値は不明)を推定したいとき、全住民を調べるのは不可能です。そこで1,000人だけサンプリングして「手元の平均値」を出します。
中心極限定理によって手元の平均値が真の平均値からどの程度ばらつきうるかがベル・カーブで計算できるため、「95% の確率で、真の平均はこの範囲に収まる」という予測(予測区間や検定)が可能になります。
メリット2:機械学習の「誤差(ノイズ)」の前提になる
機械学習のモデル(線形回帰など)では、予測値と実際の値のズレを 誤差(ノイズ)として扱います。
ノイズは無数の小さな要因(測定ミス、気温の変化、個体差など)が足し合わさって(=平均化されて)生じると考えられます。 無数の要因の足し算(平均)であるため、中心極限定理によって「誤差の分布は正規分布に従うと仮定してよい」ということになり、最小二乗法などの数式が機能します
分散 $\sigma^2 = 1$ の確率密度関数
\[f(x; \mu) = \frac{1}{\sqrt{2\pi}} \exp\left(-\frac{1}{2}(x - \mu)^2\right)\]分散 $\sigma^2 = 1$ 尤度関数
\[L(\mu) = \prod_{i=1}^{n} f(x_i; \mu) = \prod_{i=1}^{n} \frac{1}{\sqrt{2\pi}} \exp\left(-\frac{1}{2}(x_i - \mu)^2\right)\]負の対数尤度の展開
\[\begin{aligned} -\log L(\mu) &= -\log \left( \prod_{i=1}^{n} \frac{1}{\sqrt{2\pi}} \exp\left(-\frac{1}{2}(x_i - \mu)^2\right) \right) \\ &= -\sum_{i=1}^{n} \log \left( \frac{1}{\sqrt{2\pi}} \exp\left(-\frac{1}{2}(x_i - \mu)^2\right) \right) \\ &= -\sum_{i=1}^{n} \left( \log\left(\frac{1}{\sqrt{2\pi}}\right) - \frac{1}{2}(x_i - \mu)^2 \right) \\ &= -n \log\left(\frac{1}{\sqrt{2\pi}}\right) + \frac{1}{2}\sum_{i=1}^{n}(x_i - \mu)^2 \end{aligned}\]最小化すべき関数 $g(\mu)$
\[g(\mu) = \frac{1}{2}\sum_{i=1}^{n}(x_i - \mu)^2\]微分方程式
\[\frac{d}{d\mu}g(\mu) = 0\]微分と最尤推定量の導出
\[\begin{aligned} \frac{d}{d\mu}g(\mu) &= \frac{1}{2}\sum_{i=1}^{n}\frac{d}{d\mu}(x_i - \mu)^2 \\ &= \frac{1}{2}\sum_{i=1}^{n}\left(-2(x_i - \mu)\right) \\ &= \sum_{i=1}^{n}\mu - \sum_{i=1}^{n}x_i \\ &= n\mu - \sum_{i=1}^{n}x_i \end{aligned}\]となるため、
\[n\mu - \sum_{i=1}^{n}x_i = 0\]を $\mu$ について解き、$\mu$ の最尤推定量として、
\[\hat{\mu} = \frac{1}{n}\sum_{i=1}^{n}x_i\]が得られます。