混合ガウス分布 | 確率・統計
一変量正規分布(あるいは 多変量正規分布 )は、山が 1 つしかない 単峰性 の分布です。現実のデータは、山が複数ある多峰性 の分布に従うことがあります。複数の正規分布を重ね合わせた分布を混合ガウス分布( Gaussian Mixture Model, GMM )と呼びます。
直感的なイメージ
例えば成人の身長のデータを男女分けずに集めると、男性の平均身長付近の山と、女性の平均身長付近の山の、2 つの山を持つ分布になります。これは男性の身長分布(正規分布)と女性の身長分布(正規分布)を、それぞれの人数比率で混ぜ合わせたものと考えられます。
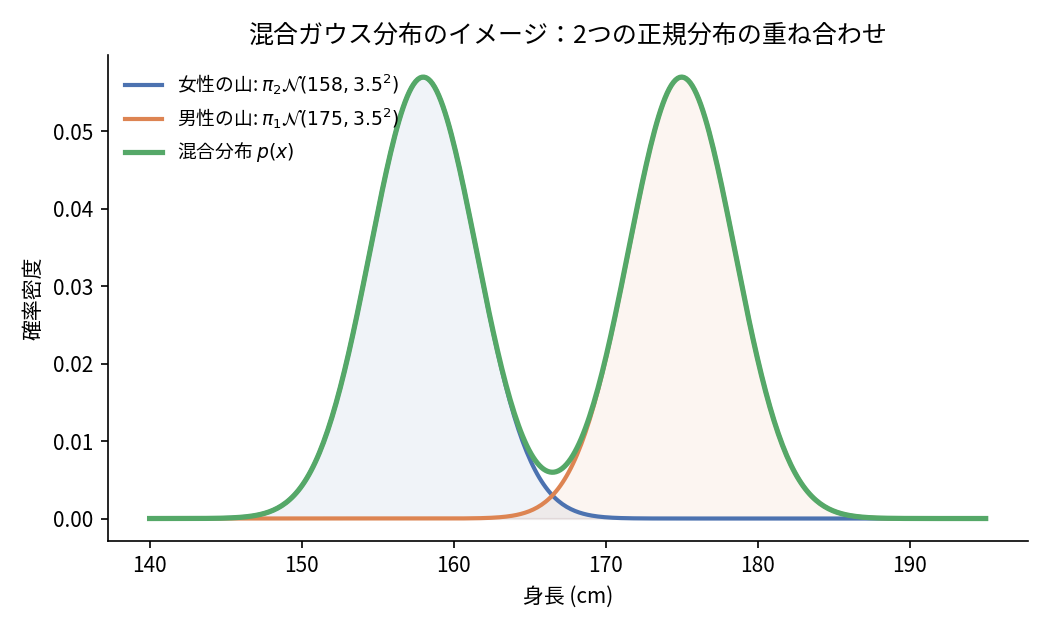
上図は $\pi_1=\pi_2=0.5$(男女半々)、女性を $\mathcal{N}(158, 3.5^2)$、男性を $\mathcal{N}(175, 3.5^2)$ とした例です。2 つの山の間( $x\approx166$ 付近)に谷ができ、混合分布 $p(x)$(緑)全体としては 多峰性 を持つ形になっています。
補足:2 つの正規分布の平均の差に対して標準偏差が大きすぎると、山同士が重なりすぎて谷が消え、見た目には 1 つの山にしか見えなくなることがあります。多峰性がはっきり現れるかどうかは、平均の差と標準偏差の大きさの相対的なバランスに依存します。
定義
$K$ 個の正規分布を、重み $\pi_k$ で混ぜ合わせたものとして定義します。
\[p(x) = \sum_{k=1}^{K} \pi_k \, \mathcal{N}(x\mid \mu_k, \sigma_k^2)\]- $K$:混合する正規分布(成分)の数
- $\pi_k$:$k$ 番目の成分が選ばれる確率(混合係数)。$\sum_{k=1}^K \pi_k = 1,\ \pi_k\ge0$ を満たす
- $\mathcal{N}(x\mid \mu_k,\sigma_k^2)$:$k$ 番目の成分分布(正規分布)
多変量の場合は各成分が多変量正規分布 $\mathcal{N}(\boldsymbol{x}\mid\boldsymbol{\mu}_k,\Sigma_k)$ になります。
\[p(\boldsymbol{x}) = \sum_{k=1}^{K} \pi_k \, \mathcal{N}(\boldsymbol{x}\mid \boldsymbol{\mu}_k, \Sigma_k)\]$\pi_k$ の解釈:潜在変数(カテゴリカル分布)との関係
混合ガウス分布は、以下のような 2 段階の生成過程として理解することもできます。
- まず、カテゴリ $k\in{1,\dots,K}$ を、確率 $\pi_k$ の カテゴリカル分布 に従って選ぶ(どの成分から生成するかを決める、観測できない潜在変数 $z$ )
- 選ばれた $k$ に対応する正規分布 $\mathcal{N}(\mu_k,\sigma_k^2)$ から $x$ を生成する
このように、混合係数 $\pi_k$ は、カテゴリカル分布 のパラメータ $\boldsymbol{p}=(p_1,\dots,p_M)$ と同じ役割( $M=K$ 個の選択肢に対する確率の割り振り)を果たしています。
具体例( $K=2$:身長の例)
上図の身長の例( $K=2$ )で、この生成過程を具体的に書き下すと以下のようになります。$K=2$ の場合、どちらの成分を選ぶかは 2 択なので、カテゴリカル分布ではなく ベルヌーイ分布(コイン投げ)とみなせます。
- コインを投げる(確率 $\pi_1=0.5$ で男性、確率 $\pi_2=0.5$ で女性を選ぶ)
- 選ばれた性別の正規分布から、身長を1つ生成する
この 1. どの山を使うか選ぶ(ベルヌーイ / カテゴリカル分布)→ 2. 選んだ山から値を生成する(正規分布)という 2 段階の生成過程が混合ガウス分布の本質です。$K$ が 2 つなら 2. の前段はベルヌーイ分布、3 つ以上ならカテゴリカル分布に一般化されるという対応関係になります。
パラメータ推定の難しさ
単一の正規分布であれば、最尤推定量 は $\hat\mu=\frac{1}{n}\sum_i x_i$ のように閉じた式で求まりました。
しかし混合ガウス分布では、対数尤度が $\log$ の中に $\sum$ がある形になり、微分して $=0$ と置いても閉じた式で解けません(どのデータ点がどの成分から来たか=潜在変数 $z$ が分からないため)。
\[\log L = \sum_{i=1}^{n} \log\left(\sum_{k=1}^{K} \pi_k\,\mathcal{N}(x_i\mid\mu_k,\sigma_k^2)\right)\]このため、実務では EMアルゴリズム(Expectation-Maximization Algorithm)という反復的な最適化手法が使われます。
- Eステップ:現在のパラメータのもとで、各データ点が各成分に属する確率(負担率)を計算する
- Mステップ:その負担率で重み付けしながら、各成分のパラメータ( $\pi_k,\mu_k,\sigma_k^2$ )を更新する
この 2 ステップを収束するまで繰り返します。
機械学習での位置づけ
- クラスタリング:$K$-means の確率的な一般化とみなせ、各データ点が「柔らかく」(確率的に)複数のクラスタに属することを許容する
- 密度推定:複雑な多峰性のデータ分布を、単純な正規分布の組み合わせで近似的に表現する
- 異常検知:推定した分布から見て確率密度が極端に低いデータ点を異常とみなす